
歯科SEOのrobots.txtクロール制御とは?noindexとの違いと確認方法
2026年9月26日
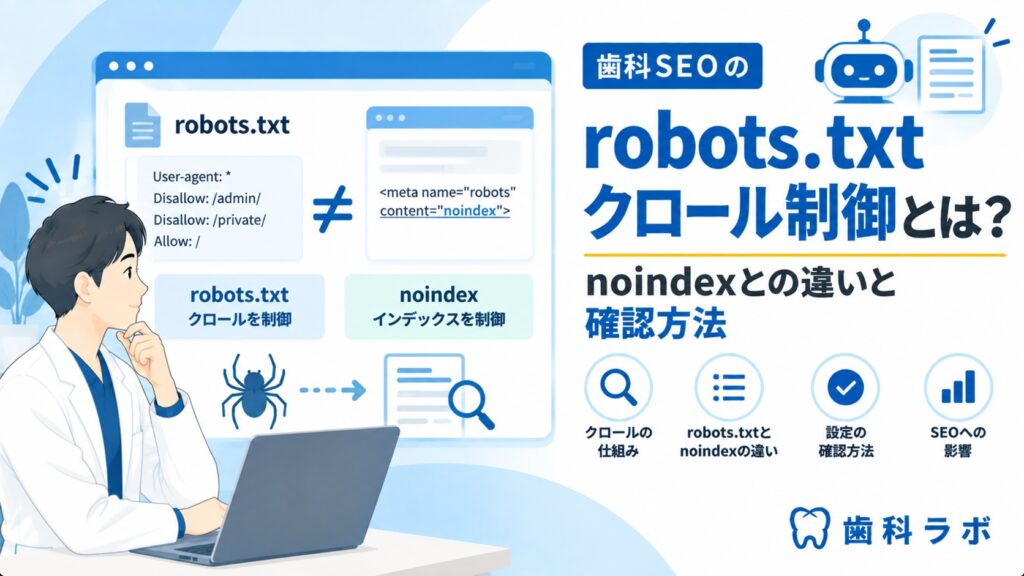
robots.txtと対象URLの現在設定を確認する
歯科医院のホームページにおけるrobots.txtの設定と対象URLの状態を正しく把握することは、Googlebotがサイトをクロールできるかどうかを判断するうえで最初に確認すべき重要なポイントです。具体的には、robots.txtファイルで対象となるURLがGooglebotに対してクロール許可されているか、拒否されているかを明確に確認し、さらに対象ページのHTMLやHTTPヘッダーに問題がないかを検証します。
robots.txtは、検索エンジンのクローラーに対してアクセス制御を行うためのファイルであり、特定のURLやディレクトリをクロールさせたくない場合に利用します。しかし、意図しないURLをクロール拒否してしまうと、検索結果に表示されなくなる可能性があるため、設定内容は慎重に確認する必要があります。
確認の際は、まずrobots.txtファイルの記述内容を直接確認し、対象URLがどのように指定されているかを把握します。次に、対象ページのHTMLソースやHTTPヘッダーでrobots metaタグやX-Robots-Tagヘッダーが設定されていないかも確認します。これらはクロール制御だけでなく、インデックス登録の制御にも影響するため、robots.txtとは別の役割として区別して理解することが重要です。
また、GoogleのSearch ConsoleにあるURL検査ツールを活用し、実際にGooglebotがそのURLをどのように認識しているかを調べます。URL検査では、クロールの許可・拒否状況やインデックス登録の状態がわかるため、robots.txtの設定と実際のクロール状況の整合性を確認するのに役立ちます。
これらの確認においては、対象URLと照らし合わせて状態を整理し、設定差分やエラーの有無、再現条件などを正確に把握することがポイントです。さらに、robots.txtによるクロール制御とrobots metaタグによるインデックス制御は別のものとして混同しないよう注意します。
設定内容の確認と記録が終わったら、修正が必要な場合は変更を加えたうえで、同じURLを再度URL検査ツールでチェックし、変更が反映されているかを確認します。この一連の流れを確実に行うことで、意図しないクロール拒否を防ぎ、適切なインデックス登録につなげることができます。
これらの情報を揃えて、変更前後での状態変化を比較し、問題が解消されているかどうかを判断します。
なお、robots.txtの設定は検索順位を保証するものではなく、サーバー負荷対策の全般ではないことも理解しておく必要があります。検索結果からの除外手段としてrobots.txtを利用するのは誤りであり、正しくはnoindexタグで制御することが推奨されます。
このように、robots.txtと対象URLの現在設定を正しく把握し、Googlebotがクロール可能かどうかを判断することが、歯科SEOにおける基本の一歩となります。具体的な確認方法や改善の進め方については、以下の手順を参考にしてください。
具体的な確認手順
- robots.txtファイルの内容を確認する
- サイトのルートディレクトリにあるrobots.txtを開き、対象URLが許可・拒否されているかをチェックします。
- 対象ページのHTMLとHTTPヘッダーを確認する
- ページソースを確認し、robots metaタグの有無やX-Robots-Tagヘッダーの設定を調べます。
- Google Search ConsoleのURL検査ツールを利用する
- 対象URLを入力し、クロール状況やインデックス登録の状態を確認します。
- Observable Signalsを整理する
- 対象URLの現在状態、エラーの有無、設定差分、再現条件などを記録します。
- 必要に応じて設定を修正し、再度URL検査で確認する
この流れを踏むことで、robots.txtによるクロール制御の現状を正確に把握し、意図しないクロール拒否やインデックス制御との混同を避けることができます。これが歯科医院のホームページにおけるSEO対策の基盤となるため、定期的に確認し、必要に応じて改善を行うことが大切です。
クロール制御とnoindexの役割を分けて判断する
歯科SEOにおいてrobots.txtによるクロール制御とrobots metaタグのnoindexによるインデックス制御は、それぞれ異なる目的と役割を持ちます。これらを混同せずに分けて判断することが、意図しないクロール拒否やインデックス登録の問題を正確に診断し、適切な修正を行うために不可欠です。
まず、robots.txtはGooglebotなどの検索エンジンのクローラーが特定のURLへアクセス(クロール)することを許可または拒否するための設定です。これに対して、robots metaのnoindexは、クロールは許可されていても検索結果にそのページを表示させない(インデックスさせない)ための指示となります。
この違いを踏まえ、クロール制御とnoindexの役割を分けて判断するには、以下のポイントを比較検証します。
- robots.txtの設定と対象URLの状況: まずrobots.txtで該当URLがクロール拒否されていないかを確認します。実際のrobots.txtファイルの内容と、対象URLがそのルールに該当するかをチェックします。
- 対象ページのrobots metaタグの有無: 対象ページのHTMLヘッダーを確認し、robots metaタグにnoindexが指定されているかを調べます。noindexがある場合はインデックス登録を拒否していることになります。
- URL検査ツールでの状況確認: Google Search ConsoleのURL検査を用いて、GooglebotがどのようにそのURLを認識しているか、クロールの許可状況やインデックス登録状況を確認します。
- エラーや設定差分の把握: robots.txtの設定変更やmetaタグの追加・削除の差分を把握し、問題の原因がどちらの制御に起因しているかを特定します。
これらの確認を通じて、例えばrobots.txtでクロール拒否されている場合は、Googlebotがページにアクセスできず、クロールされないことが原因です。一方、robots.txtでクロールは許可されているがrobots metaのnoindexがある場合は、クロールはされるもののインデックス登録を拒否している状態です。
修正対象を決める際はこの違いを明確にし、クロール制御の誤設定を直すのか、インデックス制御の設定を見直すのかを判断します。例えば、意図せずクロール拒否している場合はrobots.txtの許可設定を見直すべきですし、インデックス登録を望まないページであればnoindex設定が適切かどうかを検討します。
また、これらの判断は単独の指標で行わず、複数の根拠を照らし合わせることが重要です。Search Consoleのクロール状況、URL検査の結果、robots.txtの実際の設定、対象ページのHTMLソースなど、総合的に判断して初めて正しい修正対象が見えてきます。
Googlebotがサイトをクロールできるかどうかを判断するうえで最初に確認すべき重要なポイントです。
このようにクロール制御とnoindexの役割を分けて判断することで、意図しないクロール拒否やインデックス制御の混同による誤った対応を防ぎ、効果的なSEO改善につなげられます。修正対象が特定できたら、優先順位を付けて対応し、修正後は必ず同じURLを再度URL検査などで確認することをおすすめします。
修正後に同じURLを再確認する
修正後には、変更を加えたURLについて、変更前と同じ条件で状態を比較し、期待した通りにrobots.txtの設定が反映されているかを必ず再確認しましょう。具体的には、robots.txtの対象URLに対するGooglebotのクロール許可・拒否が正しく設定されているか、またnoindexなどのmetaタグによるインデックス制御と混同がないかを検証します。
この再確認は、単に変更が適用されたかどうかを見るだけでなく、対象URLのクロール状況やインデックス登録状況に意図しない影響が出ていないかを詳細にチェックすることが重要です。例えば、robots.txtでクロールを許可していても、ページ内にnoindexタグがあればインデックスされませんし、逆にrobots.txtで拒否しているのにnoindexのみで対応している場合はクロール拒否とインデックス制御の区別がつかず、診断が困難になります。
再確認の具体的な手順としては、まずrobots.txtファイルの設定を確認し、対象URLが正しく許可または拒否されているかを確かめます。次に、そのURLのHTMLやHTTPヘッダーを調査し、robots metaタグにnoindexが設定されていないかを確認します。さらにGoogle Search ConsoleのURL検査ツールを利用し、そのURLのクロール状況やインデックス登録状態を最新の情報でチェックします。これらの情報を揃えて、変更前後での状態変化を比較し、問題が解消されているかどうかを判断します。
修正内容と確認結果は対応させて記録し、次回以降の検証や改善に役立てることが望ましいです。こうした一連の再確認を怠ると、意図しないクロール拒否やインデックス制御の誤解が続き、SEO対策の効果が得られないリスクが高まります。


